هذه المادة صاحب فكرتها أحد نماذج الذكاء الاطناعي، وقد كتبهابنفسه، بما فيها العنوان، وبالطريقة التي يتخيل فيها المستقبل، فهل نحن أمام مشكلة حقيقة أم أمام حلول لا تقف عاجزة أمام المشاكل؟
ندعكم مع المادة حرفيًا:
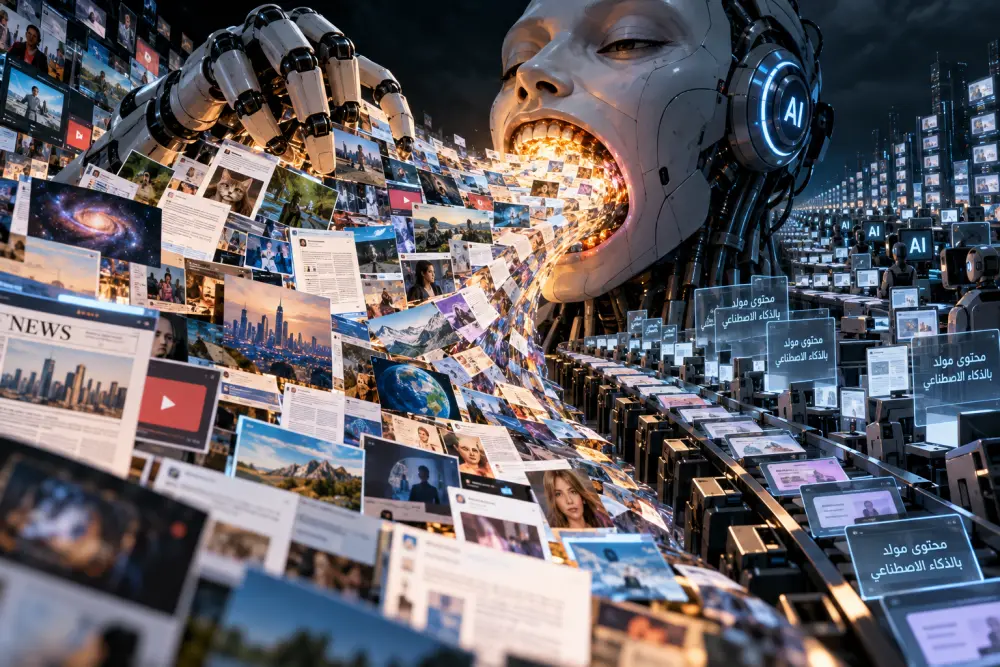
قبل سنوات، كان الإنترنت ذاكرة البشر التي يتعلم منها الذكاء الاصطناعي. اليوم، بدأ الذكاء الاصطناعي يكتب هذه الذاكرة بنفسه. ملايين المقالات والصور والمراجعات والتعليقات والمقاطع الاصطناعية تتدفق يوميًا إلى الشبكة، وفي المستقبل قد تعود هذه المواد نفسها إلى مختبرات التدريب باعتبارها «بيانات».
لكن شيئًا غريبًا بدأ يحدث.
الآلة التي تعلمت من الإنترنت أصبحت الآن واحدة من أكبر منتجي المحتوى فيه. مقالات تُكتب في ثوانٍ، وصور لم تلتقطها كاميرا، ومقاطع فيديو لأحداث لم تقع، ومراجعات لمنتجات ربما لم يجربها أحد، وتعليقات ومنشورات وتقارير وصفحات كاملة يمكن إنتاجها آليًا بأعداد هائلة.
ومع كل جيل جديد من نماذج الذكاء الاصطناعي يظهر سؤال لم يكن مطروحًا عندما بدأت هذه الثورة: من أين ستتعلم الآلة المقبلة إذا أصبح جزء متزايد من الإنترنت من إنتاج الآلات السابقة؟
قد يبدو الأمر كمن ينسخ كتابًا عن نسخة من الكتاب نفسه، ثم ينسخ النسخة الثالثة عن الثانية، والرابعة عن الثالثة. في البداية تكاد الفروق لا تُرى، لكن خطأ صغيرًا في كل نسخة يمكن أن يتراكم حتى يصبح النص الأخير مختلفًا عن الأصل.
هذه، بصورة مبسطة، واحدة من أكثر المشكلات غرابة التي يناقشها باحثو الذكاء الاصطناعي اليوم: ماذا يحدث عندما يبدأ الذكاء الاصطناعي في «أكل» المحتوى الذي أنتجه بنفسه؟
الآلة تتعلم من صورتها عن العالم
النماذج اللغوية الكبيرة لا تعرف العالم بالطريقة التي يعرفه بها الإنسان. إنها تتعلم أنماطًا موجودة في كميات هائلة من النصوص والبيانات، ثم تستخدمها لتوقع ما ينبغي أن يأتي لاحقًا.
عندما تكون المادة الأصلية مكتوبة بواسطة البشر، فإنها تحمل فوضى العالم الحقيقي وتنوعه: الأسلوب الجيد والرديء، الرأي الشائع والنادر، اللغة الرسمية والعامية، الوقائع المعتادة والاستثناءات الغريبة.
لكن النموذج حين ينتج نصًا لا يعيد كل هذا التنوع بالضرورة. إنه يميل إلى إنتاج الأنماط الأكثر احتمالًا وفق ما تعلمه.
وهنا تبدأ المشكلة.
إذا استُخدمت مخرجاته لتدريب نموذج آخر، ثم استخدمت مخرجات النموذج الثاني لتدريب ثالث، يمكن أن تصبح بعض الأشياء الشائعة أكثر شيوعًا، بينما تختفي تدريجيًا التفاصيل والاستثناءات الأقل حضورًا.
وأطلق باحثون على إحدى صور هذه الظاهرة اسم «انهيار النموذج» Model Collapse.
في دراسة نشرتها مجلة «نيتشر»، وجد الباحثون أن الاستخدام المتكرر وغير المنضبط لبيانات مولدة بواسطة النماذج لتدريب أجيال لاحقة يمكن أن يؤدي إلى تدهور تدريجي؛ إذ تبدأ النماذج بفقدان أجزاء من التوزيع الأصلي للبيانات، خصوصًا المعلومات الأقل شيوعًا.
أي أن الآلة لا تنسى الحقيقة الأشهر أولًا، بل قد تبدأ بنسيان الأشياء النادرة.
وهذا ربما يكون الجانب الأخطر.
لأن العالم لا يتكون فقط مما يحدث كثيرًا.
المرض النادر، واللهجة المحلية، والحادثة الاستثنائية، والرأي غير المعتاد، والأسلوب الأدبي المختلف، والتجربة الإنسانية التي لا تشبه ملايين التجارب الأخرى، كلها تقع في أطراف البيانات التي قد يكون الحفاظ عليها أصعب إذا أعادت الآلات تدوير إنتاجها جيلاً بعد جيل.
تجربة انتهت بأرانب
قدمت إحدى التجارب التي ناقشتها «نيتشر» مثالًا يكاد يبدو ساخرًا.
بدأ الباحثون بنص يتعلق بالعمارة في العصور الوسطى، ثم دربوا أجيالًا متتابعة باستخدام بيانات أنتجتها النماذج السابقة. وبعد عدة أجيال، انحرف الناتج بعيدًا عن المادة الأصلية حتى انتهى إلى حديث لا علاقة له تقريبًا بالموضوع الأول، من بينها إشارات إلى الأرانب البرية.
المغزى لم يكن أن كل نظام ذكاء اصطناعي سيتحول بعد تسعة أجيال إلى إنتاج كلام عبثي، وإنما أن الأخطاء والانحرافات التي تبدو صغيرة في جيل واحد يمكن أن تتضخم عندما تصبح مخرجات ذلك الجيل «حقيقة تدريبية» للجيل التالي.
إنها دائرة غير مألوفة: النموذج الأول يقدم تصورًا ناقصًا عن الواقع، والثاني يتعلم من هذا التصور، والثالث يتعلم من نسخة أكثر ابتعادًا عن الواقع.
وبمرور الوقت قد لا تكون الآلة تتعلم من العالم، بل من ذاكرة صناعية متراكمة عن العالم.
إنترنت لا نعرف من كتبه
المشكلة لا تقع داخل المختبرات وحدها.
في السابق كان بإمكان مطوري الذكاء الاصطناعي جمع كميات ضخمة من البيانات المنشورة على الإنترنت مع افتراض معقول بأن معظمها من إنتاج البشر.
هذا الافتراض أصبح أكثر صعوبة.
فالمحتوى الاصطناعي لا يحمل دائمًا بطاقة تقول إن آلة أنتجته. يمكن نسخ إجابة مولدة بالذكاء الاصطناعي ووضعها في مدونة، ثم اقتباسها في موقع آخر، ثم تلخيصها في موقع ثالث، حتى تضيع معرفة أصل النص تمامًا.
والأمر أكثر تعقيدًا مع الصور.
صورة يصنعها الذكاء الاصطناعي اليوم قد تنشرها آلاف الحسابات، ثم تظهر بعد سنوات في مجموعة بيانات جديدة من دون أي إشارة واضحة إلى أنها لم تكن صورة حقيقية أصلًا.
وهكذا يمكن للمحتوى الاصطناعي أن يعود إلى الآلة التي أنشأته، متنكرًا في هيئة معرفة مستقلة.
ولهذا أصبح «أصل المحتوى» قضية تقنية متزايدة الأهمية. وتعمل مبادرات مثل معيار C2PA على إنشاء بيانات اعتماد رقمية تساعد على توثيق مصدر الملفات والتعديلات التي طرأت عليها، في محاولة لإنشاء سجل يمكن من خلاله تتبع تاريخ الصور والفيديوهات وغيرها من المحتوى.
لكن الإنترنت أكبر كثيرًا من أن يحمل كل ملف فيه شهادة ميلاد رقمية موثوقة.
هل يصبح المحتوى البشري سلعة نادرة؟
هنا تظهر مفارقة اقتصادية مثيرة.
الذكاء الاصطناعي يستطيع إنتاج النصوص بتكلفة شديدة الانخفاض، لكن انتشار هذه النصوص قد يجعل المحتوى الذي نعرف يقينًا أن إنسانًا كتبه أكثر قيمة.
قد تصبح قواعد البيانات القديمة، وأرشيفات الصحف، والكتب، والموسوعات، والسجلات العلمية، والمحادثات البشرية الموثقة موارد مرغوبة ليس لأنها قديمة فحسب، بل لأنها تعود إلى زمن كانت فيه احتمالية أن يكون المحتوى قد أنتج بواسطة نموذج توليدي أقل بكثير.
وتشير أبحاث «انهيار النماذج» بالفعل إلى أن البيانات الناتجة عن تفاعلات بشرية حقيقية يمكن أن تصبح أكثر أهمية مع انتشار المحتوى المولد آليًا على الإنترنت.
وهذا يساعد على تفسير جانب من السباق الجاري للحصول على بيانات عالية الجودة.
فشركات الذكاء الاصطناعي لا تبحث فقط عن «المزيد من الكلمات»، بل عن بيانات يمكن معرفة مصدرها وجودتها، ومن بينها مواد تنتجها مؤسسات إعلامية وناشرون وباحثون ومختصون.
وقد يتحول السؤال مستقبلًا من: كم تملك من البيانات؟ إلى: كم تملك من البيانات التي تعرف من أنتجها؟
الصحافة أمام معضلة جديدة
بالنسبة إلى الصحافة، المسألة أكثر حساسية.
تخيل خبرًا غير صحيح أنتجه نظام آلي، ثم نُشر في عشرات المواقع التي تعتمد على التوليد الآلي. بعد ذلك تجمع محركات البحث هذه الصفحات، وتتعامل معها أنظمة أخرى باعتبار كثرة تكرار المعلومة دليلًا على انتشارها.
يمكن عندئذ أن تنشأ دائرة غريبة: آلة تنتج معلومة، ومواقع آلية تكررها، ومحرك يكتشف أنها موجودة في عدة أماكن، ثم تستخدم آلة أخرى هذه الصفحات للإجابة عن سؤال القارئ.
مصدر «الحقيقة» في هذه السلسلة قد لا يكون شاهدًا ولا وثيقة ولا صحفيًا.
قد يكون نموذجًا آخر.
وهنا تتجاوز المشكلة جودة الذكاء الاصطناعي لتصل إلى جودة الإنترنت نفسه.
إذا ارتفعت نسبة المحتوى الرخيص والمكرر والمولد آليًا، تصبح مهمة العثور على المعرفة الأصلية أكثر تكلفة، ويزداد وزن المؤسسات التي تنتج معلوماتها من مصادر أولية: مراسل في موقع الحدث، وباحث يجري تجربة، ومحكمة تصدر حكمًا، وهيئة تنشر رقمًا رسميًا، وطبيب يوثق حالة، ومصور يلتقط ما وقع بالفعل.
وقد يصبح أحد أهم أدوار الصحافة في عصر الذكاء الاصطناعي ليس فقط كتابة الأخبار، بل إنتاج مادة أصلية عن الواقع تستطيع الآلات نفسها الاعتماد عليها لاحقًا.
لكن البيانات الاصطناعية ليست عدوًا
مع ذلك، سيكون من الخطأ اعتبار كل بيانات ينتجها الذكاء الاصطناعي مادة ملوثة.
فالبيانات الاصطناعية أصبحت أداة مهمة في تطوير الأنظمة الحديثة، ويمكن استخدامها لتغطية حالات يصعب الحصول على بيانات حقيقية عنها، أو زيادة تمثيل حالات نادرة، أو تدريب الأنظمة في مجالات تحيط ببياناتها قيود تتعلق بالخصوصية.
وتستخدم شركات الذكاء الاصطناعي بالفعل بيانات اصطناعية ضمن عمليات تطوير النماذج، كما تشير دراسات إلى فوائدها في مجالات من بينها الطب عندما تستخدم بطريقة منضبطة وتخضع للتحقق.
بل إن أبحاثًا أخرى تحدت الصورة الأكثر تشاؤمًا لـ«انهيار النماذج».
فالمشكلة لا تعني أن مجرد رؤية النموذج لبيانات اصطناعية ستؤدي إلى انهياره. أظهرت تجارب أن الاحتفاظ بالبيانات الحقيقية ودمجها مع البيانات الاصطناعية، بدل استبدالها بالكامل جيلاً بعد جيل، يمكن أن يمنع السيناريو الكارثي في ظروف معينة.
الفارق إذن يشبه الفرق بين استخدام نسخة للمساعدة في دراسة الأصل، وبين التخلص من الأصل نهائيًا ثم الاستمرار في نسخ النسخ.
البيانات الاصطناعية قد تكون أداة قوية.
لكن وجود مرجع متصل بالعالم الحقيقي يظل حاسمًا.
المشكلة ليست الكذب فقط
وغالبًا ما ينحصر النقاش حول المحتوى الاصطناعي في المعلومات الكاذبة أو «الهلوسة».
لكن انهيار النماذج يكشف خطرًا أكثر خفاءً.
قد لا تكذب الآلة بوضوح، لكنها يمكن أن تجعل العالم أكثر تجانسًا.
فإذا فضلت النماذج باستمرار التعبير الأكثر شيوعًا، والقصة الأكثر نمطية، والصورة الأقرب إلى المتوسط، ثم أعادت الأجيال التالية التعلم من هذا المحتوى، قد تتعرض الأشياء الأقل انتشارًا للتآكل.
والنتيجة المحتملة ليست إنترنت مليئًا بالأخطاء فقط، بل إنترنت يبدو صحيحًا وسلسًا ومقنعًا، لكنه أقل تنوعًا من العالم الذي يفترض أنه يمثله.
اللهجات الصغيرة قد تتراجع أمام اللغة المعيارية.
الآراء النادرة قد تصبح أقل ظهورًا.
الحالات الاستثنائية يمكن أن تبدو للآلة كأنها ضوضاء إحصائية.
والأفكار الغريبة التي قد تكون بداية اكتشاف جديد يمكن أن تخسر أمام الإجابات التي تشبه ما قيل مليون مرة من قبل.
حين تصبح الحقيقة موردًا
ربما لهذا السبب سيكون أحد أغلى موارد عصر الذكاء الاصطناعي شيئًا لم يكن أحد يفكر في تسعيره بهذه الطريقة من قبل:
الواقع الخام.
نص كتبه شخص بالفعل.
صورة التقطت في مكان حقيقي.
تجربة أجراها مختبر.
معلومة تحقق منها صحفي.
حديث بشري لم تصنعه خوارزمية.
كلما ازدادت قدرة الآلات على تصنيع بيانات تبدو حقيقية، زادت قيمة البيانات التي نستطيع إثبات أنها جاءت من الواقع.
والمفارقة أن الذكاء الاصطناعي، الذي بدأ رحلته بالتعلم من بحر شبه مجاني من المعرفة البشرية المنشورة على الإنترنت، قد يجعل المعرفة البشرية الأصلية نفسها أكثر ندرة وأعلى قيمة.
ولذلك لن يكون التحدي أمام الجيل القادم من الذكاء الاصطناعي مجرد بناء نموذج أكبر أو أسرع.
سيكون السؤال الأصعب: كيف نمنعه من أن ينسى العالم الحقيقي؟
فالآلة التي تلتهم الإنترنت قد تصبح أكثر معرفة في الظاهر، وأكثر طلاقة، وأسرع في الإجابة.
لكن إذا جاء اليوم الذي تتعلم فيه الآلات أساسًا مما كتبته الآلات، ثم تنتج مواد تتعلم منها آلات أخرى، فقد نجد أنفسنا أمام شبكة هائلة تعيد تدوير صورتها عن الواقع بلا نهاية.
وعندها لن يكون السؤال: هل يستطيع الذكاء الاصطناعي أن يكتب مثل البشر؟
بل:
هل سيبقى على الإنترنت ما يكفي من البشر ليتعلم منهم؟